1. Le problème n'est pas seulement le temps de calcul
Validation des requêtes, calcul des fingerprints, admission dans une file, transitions d'état, écritures atomiques, reprise après incident et présentation des erreurs sont des comportements logiciels ordinaires. Aucun ne devrait avoir besoin d'un modèle de diffusion pour être vérifié.
Si tous les tests chargent les poids, la boucle de développement devient lente, coûteuse et ambiguë. Un échec peut provenir du réseau, des poids, de la mémoire ou de l'orchestration sans que sa cause soit immédiatement visible. La solution consiste à isoler la capacité minimale attendue du calcul : recevoir un travail résolu, produire une image et conserver sa provenance.
2. Deux chemins convergent vers le même contrat
Le serveur HTTP et l'outil de sweep ne suivent pas exactement le même chemin. L'API crée des jobs durables, les place dans une file et laisse un worker unique les exécuter. Le sweep construit directement une liste de manifestes et les transmet au runner après avoir écarté les sorties déjà présentes.
requête HTTP                    fichier de sweep
     ↓                               ↓
validation, job, file          validation, planification
     ↓                               ↓
   worker                        exécuteur du sweep
     └─────────── manifeste ───────────┘
                         ↓
                  BaseRunner.run()
                    ↙         ↘
                  stub          MFLUX
Le manifeste contient le type de job, le profil, le prompt, la seed, les dimensions, les paramètres et, selon le cas, une image parente ou les réglages du masque. Le runner ne choisit ni le prochain identifiant, ni la politique de reprise, ni le chemin de sortie : ces décisions sont déjà prises lorsqu'il reçoit le manifeste.
La classe commune prend en charge le dispatch, la mesure, l'écriture du PNG et le sidecar. Un backend n'implémente que l'opération de génération :
class BaseRunner(ABC):
    @abstractmethod
    def generate(
        self, *, prompt, seed, steps, guidance, width, height,
        image_path=None, image_strength=None,
    ) -> Image.Image:
        """Produire une image PIL."""

    def run(self, manifest: Manifest) -> Result:
        started = time.perf_counter()
        image, metrics = self.render(manifest)
        duration = round(time.perf_counter() - started, 3)
        atomic_image(Path(manifest.output), image, format="PNG")
        sidecar = self.sidecar(manifest, metrics, duration)
        atomic_json(Path(manifest.metadata), sidecar)
        return Result(
            Path(manifest.output), Path(manifest.metadata), duration, metrics
        )
Le code réel mesure aussi la durée et vérifie que le profil du manifeste est bien celui servi par le processus. Le point important est ailleurs : la logique commune d'écriture et de provenance ne peut pas diverger entre le stub et MFLUX.
3. Un moteur factice qui produit de l'information
Un stub utile ne renvoie pas une constante vide. Il construit un dégradé à partir du prompt, de la seed, des dimensions et des paramètres de génération, puis ajoute une légende lisible. Pour une édition, il mélange aussi l'image parente au résultat. Une planche contact factice reste donc exploitable pour inspecter un sweep et sa filiation.
material = f"{prompt}|{seed}|{steps}|{guidance}|{width}x{height}"
rng = np.random.default_rng(_stable_seed(material))
image = _gradient(width, height, rng)

if image_path is not None:
    source = Image.open(image_path).convert("RGB")
    source = source.resize((width, height), Image.Resampling.LANCZOS)
    image = Image.blend(source, image, 0.45)
Deux exécutions identiques produisent le même PNG octet par octet et deux seeds différentes produisent des images différentes. Cette identité ne s'étend pas au sidecar : son horodatage et sa durée changent naturellement entre deux passages.
Le nom du runner entre dans le fingerprint. Un placeholder créé par le stub ne peut donc pas occuper le nom ou le cache d'une future sortie MFLUX.
Le stub a aussi des limites assumées. Il ne reproduit pas la sensibilité du vrai
moteur à tous les paramètres, notamment image_strength, et son déterminisme ne
prédit pas celui de MFLUX sur plusieurs machines. Il vérifie le comportement de
l'orchestration, pas la physique du modèle.
4. Ne pas charger ce que l'on ne demande pas
Le découplage serait incomplet si importer le package chargeait tout de même MLX, MFLUX ou Torch. Les dépendances lourdes sont donc des extras optionnels et le runner réel n'est importé que lorsqu'il est explicitement choisi :
def build_runner(profile, name):
    if name == "stub":
        from imagegen.runners.stub import StubRunner
        return StubRunner(profile)
    if name == "mflux":
        from imagegen.runners.mflux import MfluxRunner
        return MfluxRunner(profile)
    raise ValueError(f"unknown runner {name}")
Le même principe s'applique à la segmentation. Le segmenter n'est construit qu'au premier job masqué. Les tests utilisent un segmenter géométrique factice ; CLIPSeg, Transformers et Torch ne sont pas nécessaires pour tester les crops, le bruit déterministe et la recomposition.
5. Ce qui devient testable sans modèle
Cette séparation couvre notamment :
- la validation stricte des manifestes ;
- la planification et la reprise des sweeps ;
- la déduplication par fingerprint ;
- les réponses HTTP et la profondeur de la file ;
- les statuts
queued,running,done,failedetinterrupted; - le journal append-only et sa relecture après redémarrage ;
- la production de planches contact ;
- les crops, la segmentation factice et la recomposition ;
- l'invariant qui impose un delta nul hors du masque.
Un test du stub exprime directement le contrat de déterminisme :
def test_the_same_job_twice_is_byte_identical(tmp_path, profile):
    first = make_manifest(tmp_path, output=tmp_path / "a.png")
    second = make_manifest(tmp_path, output=tmp_path / "b.png")
    run(profile, first)
    run(profile, second)
    assert first.output.read_bytes() == second.output.read_bytes()
Les écritures sont atomiques individuellement : chaque fichier temporaire est renommé sur le même système de fichiers une fois complet. Un lecteur ne voit donc jamais un PNG ou un JSON à moitié écrit. Cela ne constitue toutefois pas une transaction englobant le PNG et son sidecar : une panne entre les deux écritures peut laisser une image complète sans ses métadonnées.
6. Ce que seul le moteur réel peut confirmer
Un double de test ne peut pas prouver :
- le chargement effectif du checkpoint et d'un encodeur de remplacement ;
- l'application des LoRA dans le bon ordre ;
- la compatibilité entre l'architecture et les adaptateurs ;
- la qualité de la segmentation sur des images réelles ;
- la consommation de mémoire et le débit ;
- la qualité visuelle du résultat.
Ces propriétés appartiennent à une petite suite de smoke tests matériels. Une image réussie ne remplace pas les tests logiciels ; elle valide seulement le chemin d'inférence réel utilisé pour la produire.
7. Une vérification reproductible
La révision 4720537
du dépôt contient 144 tests. Ils ont été exécutés dans un environnement Python
3.14.4 neuf contenant uniquement les dépendances standard et l'extra dev. Une
vérification avec importlib.util.find_spec y a confirmé l'absence de Torch,
MFLUX, MLX et Transformers.
UV_PROJECT_ENVIRONMENT=/tmp/imagegen-dev-only \
  uv sync --extra dev

UV_PROJECT_ENVIRONMENT=/tmp/imagegen-dev-only \
  uv run python -c \
  "import importlib.util; print({n: importlib.util.find_spec(n) is not None for n in ('torch', 'mflux', 'mlx', 'transformers')})"

UV_PROJECT_ENVIRONMENT=/tmp/imagegen-dev-only uv run pytest -q
UV_PROJECT_ENVIRONMENT=/tmp/imagegen-dev-only uv run ruff check src tests bench
Le 14 septembre 2026, cette procédure a produit le résultat suivant :
{'torch': False, 'mflux': False, 'mlx': False, 'transformers': False}
144 passed, 2 warnings in 2.97s
All checks passed!
Les deux avertissements proviennent de dépréciations dans les outils de test de FastAPI et Starlette ; ils ne signalent ni un test ignoré ni un échec. Installer les dépendances peut demander le réseau, mais exécuter cette suite n'en a pas besoin une fois l'environnement construit.
Un smoke test réel minimal utilise un environnement distinct :
UV_PROJECT_ENVIRONMENT=/tmp/imagegen-mflux-smoke \
  uv sync --extra dev --extra mflux

UV_PROJECT_ENVIRONMENT=/tmp/imagegen-mflux-smoke \
  uv run imagegen-sweep sweeps/example.json \
    --profile plain-4b \
    --runner mflux \
    --limit 1 \
    --out /tmp/imagegen-real-smoke-20260914
Sur une machine macOS arm64 avec MFLUX 0.19.1 et MLX 0.32.2, le runner a chargé
le checkpoint public mlx-community/flux2-klein-4b-4bit en 3,5 secondes. Il a
ensuite produit en 24,65 secondes une image de 768 × 1024 pixels, son manifeste,
son sidecar et l'index du sweep :
runner mflux ready in 3.5s
[1/1] harbour seed 1  harbour_45b9d36c0e_seed1.png  24.65s
1 produced, 0 failed
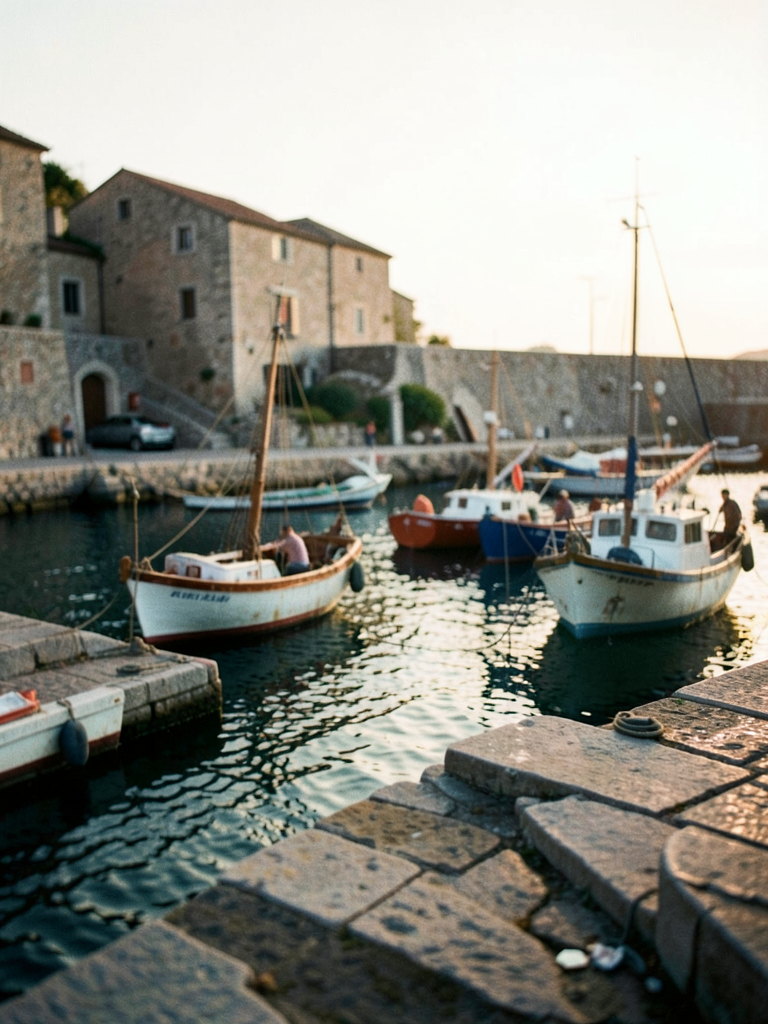
Sortie brute du smoke test, sans retouche ni sélection parmi plusieurs
variantes. Le sweep planifiait sept images, mais --limit 1 n'en a exécuté
qu'une.
Le manifeste conserve les entrées du calcul. Le sidecar ajoute l'identité effective du moteur et la mesure de l'exécution. Les deux artefacts complets peuvent être consultés ci-dessous.
Manifeste résolu
{
  "kind": "generate",
  "job_id": 0,
  "profile": "plain-4b",
  "prompt": "cinematic photograph, shallow depth of field a stone harbour at first light, fishing boats",
  "seed": 1,
  "steps": 4,
  "guidance": 1,
  "width": 768,
  "height": 1024,
  "input_image": null,
  "image_strength": null,
  "mask": null,
  "output": "/tmp/imagegen-real-smoke-20260914/harbour_45b9d36c0e_seed1.png",
  "metadata": "/tmp/imagegen-real-smoke-20260914/harbour_45b9d36c0e_seed1.metadata.json",
  "diagnostics": null
}
Sidecar complet
{
  "job_id": 0,
  "kind": "generate",
  "runner": "mflux",
  "prompt": "cinematic photograph, shallow depth of field a stone harbour at first light, fishing boats",
  "prompt_sha256": "eacd87a67ca4d826eff3aa9e842d478ac9d0a5a003860ac4ab2bca79e25ff522",
  "seed": 1,
  "steps": 4,
  "guidance": 1,
  "width": 768,
  "height": 1024,
  "input_image": null,
  "mask": null,
  "provenance": {
    "profile": "plain-4b",
    "engine": "klein-4b-stock",
    "checkpoint": "mlx-community/flux2-klein-4b-4bit",
    "model_config": "flux2_klein_4b",
    "encoder": null,
    "adapters": [],
    "bake": false
  },
  "metrics": {},
  "duration_s": 24.65,
  "created_at": "2026-09-14T01:23:28.492146+00:00"
}
Le sidecar confirme le runner mflux, le profil plain-4b, quatre pas, une
guidance de 1,0 et l'absence d'adaptateur. Ce smoke test ne vérifie donc ni les
LoRA, ni l'encodeur de remplacement, ni CLIPSeg : chacun exige un cas de test
réel supplémentaire.
8. Ajouter un autre moteur
Un nouveau backend doit charger ses ressources et implémenter generate(...)
pour retourner une image PIL. Le traitement du manifeste, le masquage, les
écritures et la provenance restent dans la classe commune ; l'API, la file et
le planificateur de sweeps n'ont pas à changer.
Cette promesse possède néanmoins une condition : le contrat ne doit pas être implicitement calqué sur MFLUX. L'ajout d'un second moteur réel serait le test le plus fort de sa généralité. En attendant, le stub prouve surtout que l'orchestration n'est pas couplée au chargement de MFLUX.
9. Conclusion
Une frontière étroite entre orchestration et inférence transforme la testabilité d'une plateforme générative. Le stub rend rapides et déterministes les tests des comportements logiciels ; le moteur réel se concentre sur les propriétés matérielles et visuelles qu'aucun double ne peut simuler.
Cette séparation ne sert pas seulement les tests. Elle prépare aussi la substitution d'un backend et l'exécution dans un processus distinct. Distribuer le calcul entre plusieurs machines demande encore d'expliciter le transport, les capacités et les pannes réseau : c'est l'étape suivante, pas une propriété déjà acquise par le seul contrat local.